Ich mag Werkzeuge, die mir Arbeit abnehmen.
Ich mag es weniger, wenn ich anschließend drei Stunden damit verbringe, ihren Organisationsplan zu pflegen.
Mein agentisches OpenClaw-Setup bewegt sich ziemlich genau zwischen diesen beiden Polen:
Ein Agent für den normalen Austausch, einer für konkrete technische Projekte und einige Spezialisten mit bewusst begrenzten Aufgaben.
Das klingt aufgeräumter, als es sich dann im Alltag wirklich anfühlt.
In diesem Artikel zeige ich, wie ich die Rollen aufteile, welche Modelle und Thinking-Stufen (Einstellungen für den Denkaufwand des Modells) ich aktuell verwende und warum ein gutes Briefing oft wichtiger ist als die nächste Agenten-Hierarchie.
Dazu gehören auch die Stellen, an denen meine Erwartungen und die tatsächliche Laufzeit am liebsten aneinander vorbeireden.
Vieles davon lässt sich auch ohne meine Rollenaufteilung nutzen:
Gezielte Briefings, überschaubarer Kontext und eine klare Verantwortung bis zum geprüften Ergebnis.
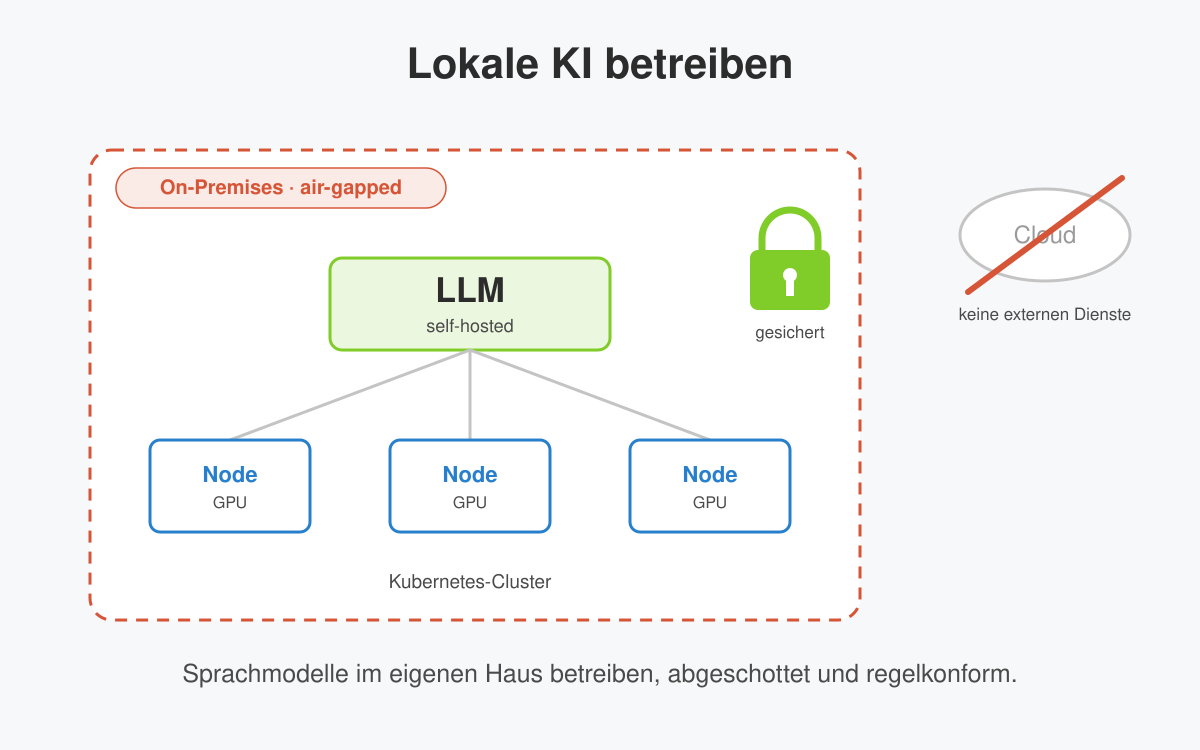
Nicht jede Organisation kann oder darf KI-Dienste in der Cloud nutzen.
Sensible Daten, regulatorische Vorgaben, Souveränitätsanforderungen und abgeschottete Netze verlangen den Betrieb von Sprachmodellen im eigenen Haus.
Das ist technisch machbar, stellt aber eigene Anforderungen an Betrieb, Sicherheit und Compliance.
Dieser Beitrag ordnet die wichtigsten ein.
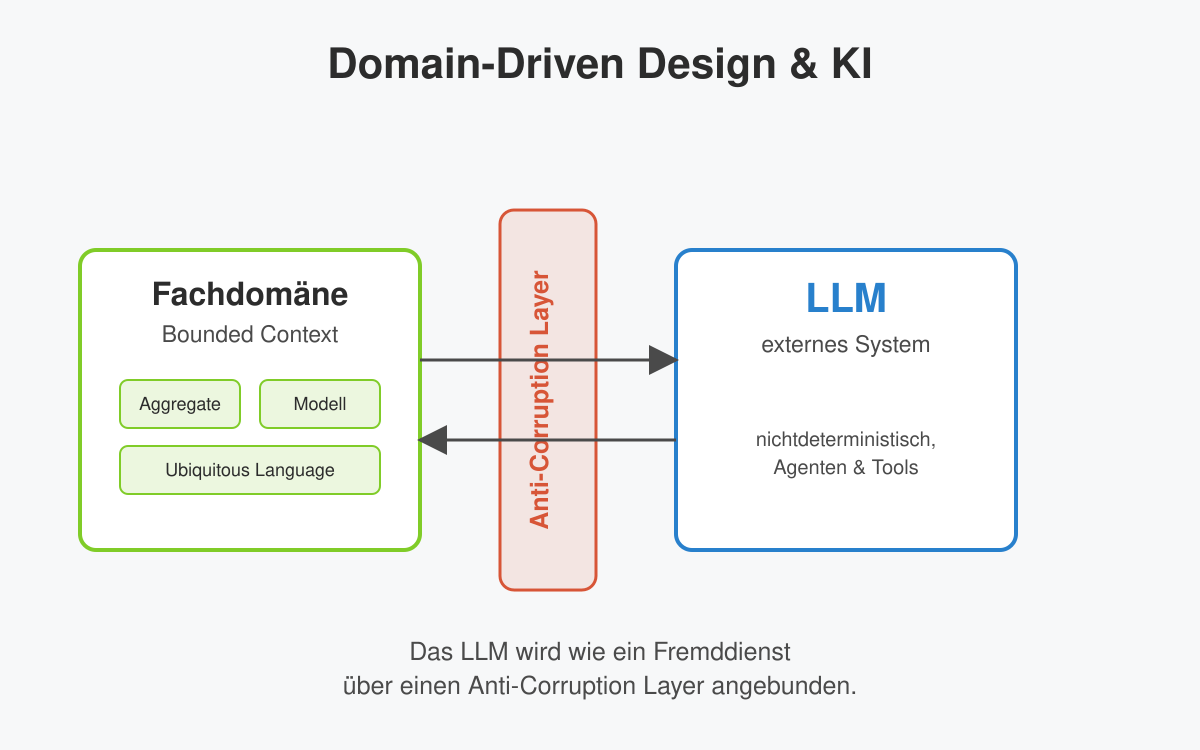
Domain-Driven Design und generative KI werden oft getrennt betrachtet.
Das eine gilt als Methodik für fachliche Modellierung, das andere als Technologiethema.
Tatsächlich berühren sich beide an mehreren Stellen, und die Verbindung ist tragfähiger, als es auf den ersten Blick wirkt.
In diesem Beitrag ordnen wir die Schnittmengen ein und trennen dabei zwei Richtungen, die man nicht vermischen sollte.
Wer Claude, Codex und Co. bei der Entwicklung von Spring-Anwendungen einsetzt, musste vielleicht auch schon feststellen, dass gerade neue Features des Frameworks nicht optimal verwendet werden.
Aufgrund fehlender oder veralteter Trainingsdaten erzeugen die Sprachmodelle zwar korrekten, aber nicht optimalen Code.
Sie definieren Beans, obwohl diese mittlerweile aus einer Autoconfiguration kommen, nutzen veraltete Klassen (z. B. JdbcTemplate statt JdbcClient) oder entpacken munter JARs, um den aktuellen Quellcode von Spring zu lesen.
In diesem Beitrag zeige ich, wie man mit Spring AI einen Model-Context-Protocol-Server (MCP-Server) für LLMs bereitstellt, der hier Abhilfe schafft.
Der Server gibt Agents Zugriff auf die Spring-Dokumentation, die für das aktuelle Projekt relevant ist.