Geschrieben von Stefan Reuter am 19. November 2026
Die Standardkonfiguration von PostgreSQL geht in vielen Punkten noch von rotierenden Festplatten aus.
Auf NVMe-SSDs, die erst mit vielen gleichzeitig ausstehenden Anfragen ihren vollen Durchsatz erreichen, bleibt damit Leistung ungenutzt.
Mit PostgreSQL 18 kam ein Subsystem für asynchrones I/O hinzu, PostgreSQL 19 baut es weiter aus und bringt Änderungen bei Autovacuum, WAL und den Standardwerten.
Dieser Beitrag geht die wichtigsten Stellschrauben für PostgreSQL 19 auf NVMe durch, prüft einige verbreitete Empfehlungen und zeigt, wie sich die Wirkung messen lässt.
Geschrieben von Stefan Reuter am 17. November 2026
Kafka verteilt die Arbeit innerhalb einer Consumer Group über Partitionen: Jede Partition wird von genau einem Consumer gelesen, der Fortschritt wird als Offset je Partition festgehalten.
Für klassische Arbeitswarteschlangen, bei denen viele Worker unabhängige Aufgaben abarbeiten, war deshalb meist ein zusätzlicher Broker wie RabbitMQ im Einsatz.
Mit KIP-932 "Queues for Kafka" gibt es nun Share Groups, mit denen sich mehrere Consumer die Records einer Partition teilen und jeden Record einzeln bestätigen.
Seit Apache Kafka 4.2 gilt die Funktion als produktionsreif, Spring for Apache Kafka unterstützt sie ab Version 4.1 vollständig.
Dieser Beitrag zeigt, wie Share Groups funktionieren, wie man sie nutzt, wo ihre Grenzen liegen und ob Kafka damit RabbitMQ ersetzen kann.
Geschrieben von Stefan Reuter am 11. November 2026
Wer Keycloak auf Kubernetes mit dem offiziellen Operator betreibt, beschreibt den Server selbst längst als Custom Resource.
Die Clients, also die Anwendungen, die sich über Keycloak anmelden, blieben bisher außen vor.
Sie wurden in der Admin-Konsole angelegt, per Realm-Import einmalig eingespielt oder mit externen Werkzeugen gepflegt.
Seit Keycloak 26.7 bringt der Operator dafür eigene Ressourcen mit: KeycloakOIDCClient und KeycloakSAMLClient.
Mit Keycloak 26.8 sind sie vom experimentellen Stand in den Preview-Status aufgerückt.
Dieser Beitrag zeigt, wie die Ressourcen funktionieren, wie sie sich im Betrieb verhalten und wann die bekannten Alternativen besser passen.
Geschrieben von Stefan Reuter am 10. November 2026
Das Model Context Protocol (MCP) hat sich als Schnittstelle etabliert, über die Sprachmodelle und Agenten auf externe Werkzeuge und Datenquellen zugreifen.
Ein MCP-Server stellt diese Werkzeuge bereit, etwa den Zugriff auf eine Datenbank, ein Ticketsystem oder eine interne API.
Sobald ein MCP-Server mehr tut, als öffentliche Informationen auszuliefern, stellt sich dieselbe Frage wie bei jeder anderen Schnittstelle: Wer darf was?
Die MCP-Spezifikation beantwortet das über OAuth 2.1, und Keycloak kann dabei die Rolle des Autorisierungsservers übernehmen.
Die offizielle Keycloak-Dokumentation beschreibt dieses Zusammenspiel inzwischen in einem eigenen Leitfaden.
Dieser Beitrag ordnet ein, worum es geht, welche Standards beteiligt sind und worauf beim produktiven Einsatz zu achten ist.
Wir haben unsere Telefonanlage auf Kubernetes umgezogen.
Dabei kam eine Funktion hinzu, die im Alltag schnell unverzichtbar wurde: Telefonkonferenzen werden transkribiert, zusammengefasst und durchsuchbar.
Jeder Teilnehmer wird auf einer eigenen Spur aufgezeichnet, Whisper erstellt daraus das Transkript und ein lokales Sprachmodell das Protokoll mit Entscheidungen und Aufgaben.
Gesucht wird in OpenSearch per Volltext und nach Bedeutung, so findet man auch Gespräche, in denen ein Begriff nicht wörtlich gefallen ist.
Alle Daten bleiben dabei im eigenen Cluster, auch die KI-Modelle laufen auf eigener Hardware.
Dieser Beitrag beschreibt den Aufbau und die Punkte, an denen wir nachjustieren mussten.
Zum Schluss geht es darum, was vor einer Aufzeichnung rechtlich zu beachten ist.
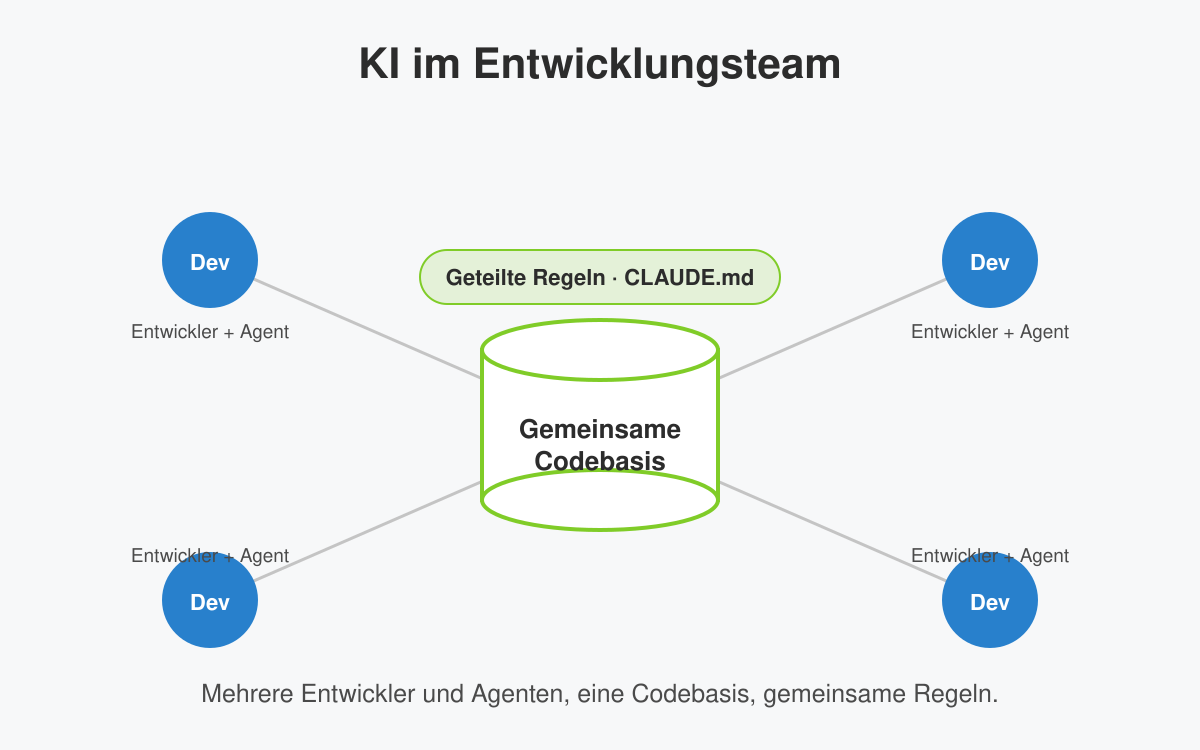
Der produktive Einsatz von KI-Werkzeugen durch einzelne Entwickler ist inzwischen gut verstanden.
Die interessantere Frage stellt sich eine Ebene höher: Was passiert, wenn ein ganzes Team KI auf derselben Codebasis einsetzt.
Hier entstehen Probleme, die sich mit individueller Produktivität nicht lösen lassen.
Dieser Beitrag ordnet die wichtigsten ein und zeigt, an welchen Stellen Teams ansetzen sollten.
Ich mag Werkzeuge, die mir Arbeit abnehmen.
Ich mag es weniger, wenn ich anschließend drei Stunden damit verbringe, ihren Organisationsplan zu pflegen.
Mein agentisches OpenClaw-Setup bewegt sich ziemlich genau zwischen diesen beiden Polen:
Ein Agent für den normalen Austausch, einer für konkrete technische Projekte und einige Spezialisten mit bewusst begrenzten Aufgaben.
Das klingt aufgeräumter, als es sich dann im Alltag wirklich anfühlt.
In diesem Artikel zeige ich, wie ich die Rollen aufteile, welche Modelle und Thinking-Stufen (Einstellungen für den Denkaufwand des Modells) ich aktuell verwende und warum ein gutes Briefing oft wichtiger ist als die nächste Agenten-Hierarchie.
Dazu gehören auch die Stellen, an denen meine Erwartungen und die tatsächliche Laufzeit am liebsten aneinander vorbeireden.
Vieles davon lässt sich auch ohne meine Rollenaufteilung nutzen:
Gezielte Briefings, überschaubarer Kontext und eine klare Verantwortung bis zum geprüften Ergebnis.
Im Brotli Decoder von Google gibt es mit CVE-2026-111497 eine Schwachstelle, bei der ein speziell gestalteter Inhalt einen Schreibzugriff außerhalb vom vorgesehenen Puffer auslöst.
Betroffen sind die Versionen 1.0.3 bis 1.2.0, behoben ist die Schwachstelle in 1.0.10, 1.1.1 und 1.2.1.
Da viele Laufzeitumgebungen und Bibliotheken Brotli einbinden, etwa Node.js und Python, dauert es, bis alle Anwendungen im Cluster aktualisiert sind.
Bei manchen Anwendungen ist bisher auch gar nicht ganz klar, ob diese betroffen sind, oder nicht.
Bis zur Klärung und Behebung des Problems kann ein Ingress Controller genutzt werden, um Requests abzuweisen, die einen als Brotli deklarierten Inhalt aufweisen.
Dieser Beitrag zeigt dazu eine einfache Regel für Traefik.
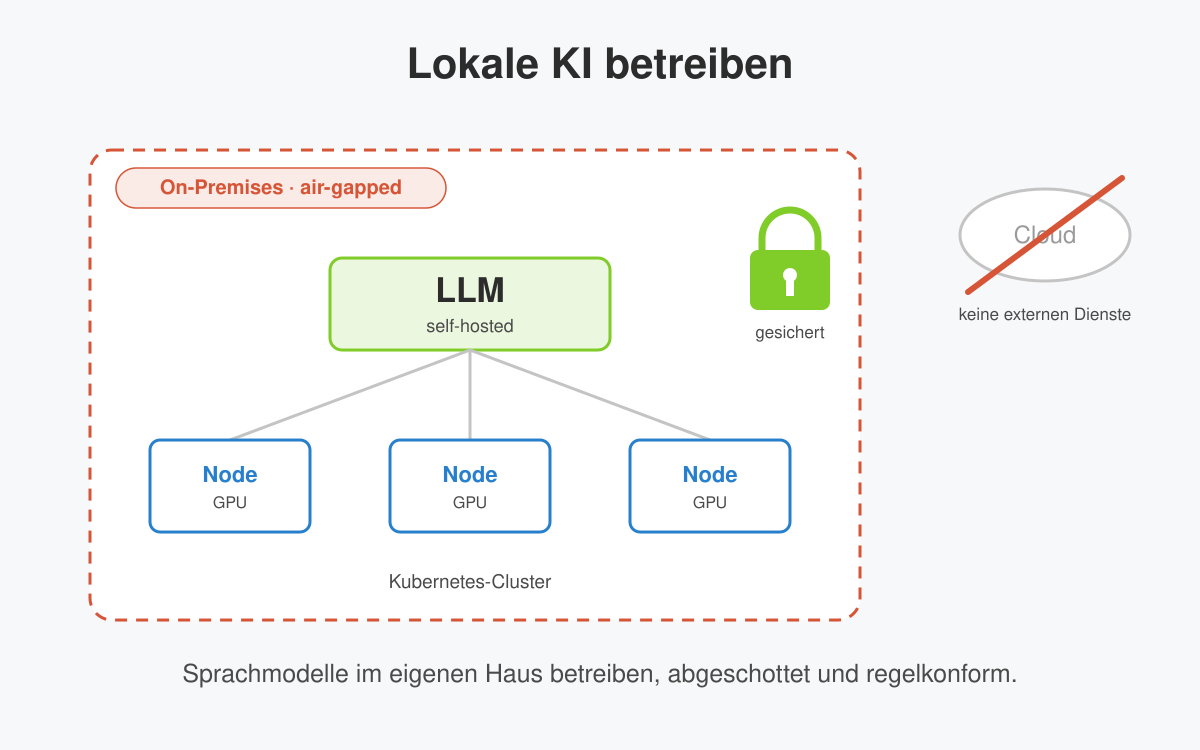
Nicht jede Organisation kann oder darf KI-Dienste in der Cloud nutzen.
Sensible Daten, regulatorische Vorgaben, Souveränitätsanforderungen und abgeschottete Netze verlangen den Betrieb von Sprachmodellen im eigenen Haus.
Das ist technisch machbar, stellt aber eigene Anforderungen an Betrieb, Sicherheit und Compliance.
Dieser Beitrag ordnet die wichtigsten ein.
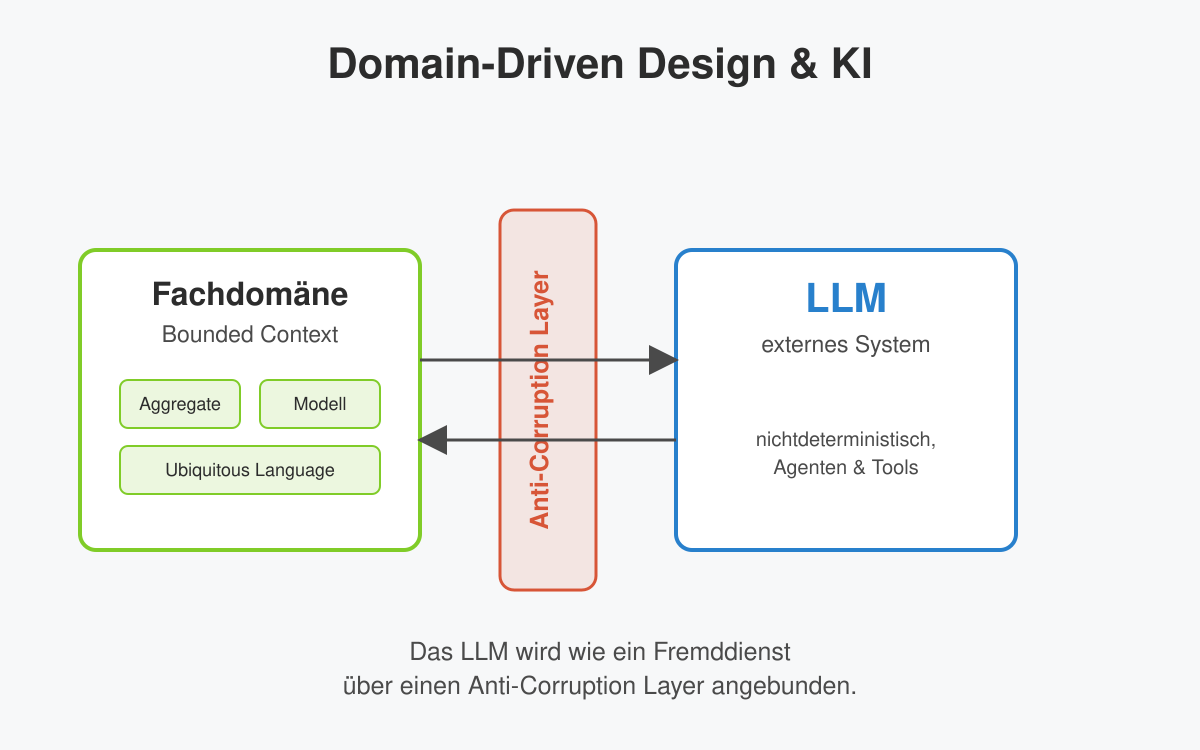
Domain-Driven Design und generative KI werden oft getrennt betrachtet.
Das eine gilt als Methodik für fachliche Modellierung, das andere als Technologiethema.
Tatsächlich berühren sich beide an mehreren Stellen, und die Verbindung ist tragfähiger, als es auf den ersten Blick wirkt.
In diesem Beitrag ordnen wir die Schnittmengen ein und trennen dabei zwei Richtungen, die man nicht vermischen sollte.