Kafka als Queue: Share Groups (KIP-932) in der Praxis und mit Spring
Kafka verteilt die Arbeit innerhalb einer Consumer Group über Partitionen: Jede Partition wird von genau einem Consumer gelesen, der Fortschritt wird als Offset je Partition festgehalten. Für klassische Arbeitswarteschlangen, bei denen viele Worker unabhängige Aufgaben abarbeiten, war deshalb meist ein zusätzlicher Broker wie RabbitMQ im Einsatz. Mit KIP-932 "Queues for Kafka" gibt es nun Share Groups, mit denen sich mehrere Consumer die Records einer Partition teilen und jeden Record einzeln bestätigen. Seit Apache Kafka 4.2 gilt die Funktion als produktionsreif, Spring for Apache Kafka unterstützt sie ab Version 4.1 vollständig. Dieser Beitrag zeigt, wie Share Groups funktionieren, wie man sie nutzt, wo ihre Grenzen liegen und ob Kafka damit RabbitMQ ersetzen kann.
Die Grenzen der Consumer Group
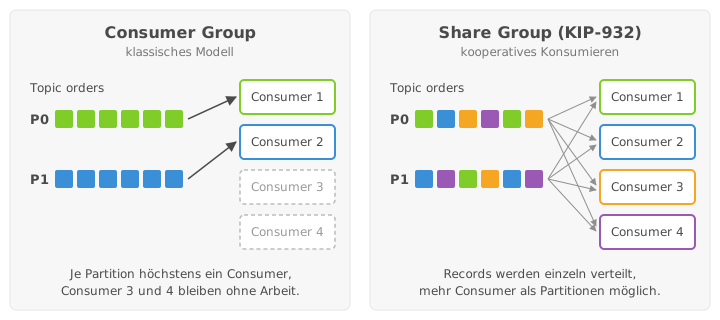
Eine Consumer Group skaliert über die Anzahl der Partitionen. Bei sechs Partitionen arbeiten höchstens sechs Consumer parallel, jeder weitere Consumer bleibt ohne Zuweisung. Mehr Parallelität erfordert mehr Partitionen, und die Partitionsanzahl eines Topics lässt sich zwar erhöhen, aber nicht wieder verringern.
Hinzu kommt, dass der Fortschritt nur als Offset je Partition gespeichert wird. Eine einzelne langsame oder fehlerhafte Nachricht hält damit alle nachfolgenden Records derselben Partition auf. Ein Consumer kann einen einzelnen Record nicht "zurückgeben", damit ein anderer ihn später erneut versucht. Wiederholungen werden deshalb in der Regel über eigene Retry- und Dead-Letter-Topics gelöst.
Für Event-Streams, bei denen die Reihenfolge je Schlüssel wichtig ist, ist dieses Modell genau richtig. Für Aufgaben wie "verschicke diese E-Mail" oder "erzeuge dieses PDF", die unabhängig voneinander und in beliebiger Reihenfolge abgearbeitet werden können, passt es weniger gut.
Share Groups: Konsumieren wie aus einer Queue
Eine Share Group ist eine neue Art von Gruppe neben der Consumer Group. Ihre Mitglieder lesen gemeinsam aus denselben Partitionen, und der Broker teilt jedem Consumer einzelne Records zu. Damit kann eine Share Group mehr Consumer haben, als das Topic Partitionen hat.
Der Broker verwaltet dafür den Zustand jedes Records, der sich gerade in Bearbeitung befindet:
-
Available: Der Record kann zugestellt werden.
-
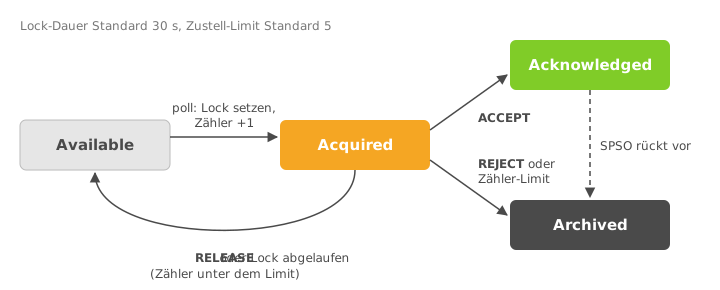
Acquired: Der Record wurde an einen Consumer ausgeliefert und ist für diesen mit einem zeitlich begrenzten Lock reserviert, standardmäßig für 30 Sekunden. Bei jeder Zustellung erhöht der Broker einen Zustellzähler.
-
Acknowledged: Der Consumer hat die Verarbeitung bestätigt.
-
Archived: Der Record wird nicht mehr zugestellt.
Der Consumer bestätigt jeden Record einzeln mit einer von drei Bestätigungsarten:
ACCEPT für erfolgreich verarbeitet, RELEASE für einen vorübergehenden Fehler, nach dem der Record erneut zugestellt werden soll, und REJECT für einen Record, der nicht verarbeitet werden kann.
Seit Kafka 4.2 kommt mit RENEW (KIP-1222) eine vierte Art hinzu, die den Lock verlängert, wenn die Verarbeitung länger dauert.
Läuft der Lock ab, etwa weil der Consumer abgestürzt ist, wird der Record wieder verfügbar und an einen anderen Consumer ausgeliefert. Erreicht der Zustellzähler das Limit, standardmäßig 5, wird der Record archiviert. Ein Record, der die Verarbeitung immer wieder scheitern lässt, blockiert die Gruppe dadurch nicht dauerhaft.
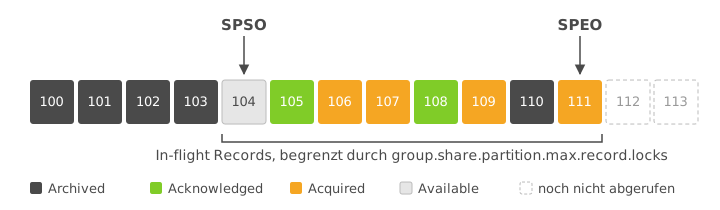
Je Partition führt der Broker ein Fenster der Records, die sich in Bearbeitung befinden.
Es beginnt beim Share-Partition Start Offset (SPSO), dem ältesten noch nicht abgeschlossenen Record, und endet beim Share-Partition End Offset (SPEO).
Sind alle Records am Anfang des Fensters bestätigt oder archiviert, rückt der SPSO vor.
Die Größe des Fensters ist über group.share.partition.max.record.locks begrenzt.
Das Topic selbst ändert sich dabei nicht. Dasselbe Topic kann gleichzeitig von Consumer Groups als Stream und von Share Groups als Queue gelesen werden, die Retention bleibt erhalten.
Nutzung mit dem Kafka-Client
In Kafka 4.0 und 4.1 waren Share Groups als Early Access und Preview enthalten, für den produktiven Einsatz sollten Broker und Client mindestens Version 4.2 haben.
Je nach Version und Historie des Clusters muss das Feature erst aktiviert werden.
Ob es aktiv ist, zeigt kafka-features.sh --bootstrap-server localhost:9092 describe, aktiviert wird es mit:
kafka-features.sh --bootstrap-server localhost:9092 \
  upgrade --feature share.version=1
Auf Client-Seite gibt es mit KafkaShareConsumer eine eigene Klasse.
Mit share.acknowledgement.mode=explicit bestätigt die Anwendung jeden Record selbst:
Properties props = new Properties();
props.put("bootstrap.servers", "localhost:9092");
props.put("group.id", "pdf-worker");
props.put("share.acknowledgement.mode", "explicit");

try (var consumer = new KafkaShareConsumer<String, String>(
        props, new StringDeserializer(), new StringDeserializer())) {
    consumer.subscribe(List.of("pdf-jobs"));
    while (true) {
        for (var record : consumer.poll(Duration.ofMillis(500))) {
            try {
                renderPdf(record.value());
                consumer.acknowledge(record, AcknowledgeType.ACCEPT);
            } catch (TransientException e) {
                consumer.acknowledge(record, AcknowledgeType.RELEASE);
            } catch (Exception e) {
                consumer.acknowledge(record, AcknowledgeType.REJECT);
            }
        }
        consumer.commitSync();
    }
}
Eine Stolperfalle beim ersten Test: Wird ein Topic neu von einer Share Group gelesen, beginnt sie standardmäßig beim neuesten Offset. Bereits vorhandene Records werden nicht zugestellt. Soll die Gruppe am Anfang des Topics beginnen, wird das als Gruppen-Konfiguration gesetzt:
kafka-configs.sh --bootstrap-server localhost:9092 \
  --entity-type groups --entity-name pdf-worker \
  --alter --add-config share.auto.offset.reset=earliest
Den Zustand einer Share Group zeigt kafka-share-groups.sh --bootstrap-server localhost:9092 --describe --group pdf-worker.
Seit Kafka 4.2 gibt es zusätzlich Lag-Metriken je Share-Partition (KIP-1226), mit Kafka 4.3 kamen weitere Gruppen-Konfigurationen wie Unter- und Obergrenzen für das Zustell-Limit hinzu (KIP-1240).
Was Share Groups bringen
-
Skalierung unabhängig von der Partitionsanzahl: Bei Lastspitzen lassen sich weitere Consumer starten, ohne das Topic umzubauen.
-
Kein Blockieren durch einzelne Records: Ein langsamer Record hält nur den Consumer auf, der ihn bearbeitet, nicht die ganze Partition.
-
Wiederholung ohne Retry-Topics:
RELEASEund abgelaufene Locks sorgen für eine erneute Zustellung, der Zustellzähler begrenzt die Anzahl der Versuche. -
Eine Plattform für Streams und Queues: Wer Kafka ohnehin betreibt, braucht für einfache Arbeitswarteschlangen keinen zweiten Broker.
-
Replay: Da die Daten im Topic bleiben, lässt sich der Startpunkt einer leeren Share Group mit
kafka-share-groups.sh --reset-offsetszurücksetzen.
Dem stehen Einschränkungen gegenüber, die man kennen sollte:
-
Keine Reihenfolge: Innerhalb eines abgerufenen Batches sind Records nach Offset sortiert, darüber hinaus gibt es keine Garantie. Erneut zugestellte Records kommen außer der Reihe. Wer die Reihenfolge je Schlüssel braucht, bleibt bei der Consumer Group.
-
Noch keine Dead-Letter-Queue: Abgelehnte oder zu oft zugestellte Records werden archiviert und damit für die Gruppe verworfen. Eine Dead-Letter-Queue für Share Groups ist mit KIP-1191 beschlossen, aber noch in Arbeit. Bis dahin muss die Anwendung Records, die sie aufbewahren möchte, vor dem
REJECTselbst in ein eigenes Topic schreiben. -
At-least-once: Läuft ein Lock ab, während die Verarbeitung noch läuft, wird der Record ein zweites Mal zugestellt. Die Verarbeitung sollte deshalb idempotent sein, und die Lock-Dauer muss zur Verarbeitungszeit passen oder per
RENEWverlängert werden.
Kann Kafka damit RabbitMQ ersetzen?
Für einen Teil der Anwendungsfälle ja. Die Kernfunktion einer Arbeitswarteschlange, also einzelne Nachrichten an konkurrierende Consumer verteilen, einzeln bestätigen und bei Fehlern erneut zustellen, bietet Kafka jetzt selbst. RabbitMQ bietet darüber hinaus Funktionen, für die Kafka kein Gegenstück hat.
| Funktion | Kafka mit Share Groups | RabbitMQ |
|---|---|---|
Verteilung an konkurrierende Consumer |
ja |
ja |
Einzelbestätigung und erneute Zustellung |
ja ( |
ja (ack, nack, requeue) |
Begrenzung der Zustellversuche |
ja (Zustell-Limit) |
ja (Delivery Limit bei Quorum Queues) |
Dead-Letter-Behandlung |
noch nicht (KIP-1191 in Arbeit) |
Dead Letter Exchanges |
Routing im Broker |
nein, Producer wählt das Topic |
Exchanges und Bindings (direct, topic, fanout, headers) |
Prioritäten, TTL je Nachricht |
nein |
ja |
Verzögerte Zustellung |
nein |
per Plugin |
Request/Reply |
nicht vorgesehen |
ja ( |
Erneutes Lesen bereits verarbeiteter Daten |
ja, über die Retention des Topics |
nur mit RabbitMQ Streams |
Protokolle |
Kafka-Protokoll |
AMQP 0-9-1, AMQP 1.0, MQTT, STOMP |
Daraus ergibt sich eine einfache Einordnung: Wer Kafka bereits betreibt und RabbitMQ nur für einfache Arbeitswarteschlangen nutzt, kann diese Fälle auf Share Groups umstellen und spart den Betrieb eines zweiten Systems. Das betrifft typischerweise Hintergrundjobs, die Verarbeitung eingehender Dokumente oder das Abarbeiten von Events, bei denen die Reihenfolge keine Rolle spielt.
RabbitMQ bleibt die bessere Wahl, wenn Nachrichten im Broker anhand von Routing-Regeln verteilt werden, Prioritäten oder Ablaufzeiten je Nachricht nötig sind, Request/Reply genutzt wird oder Clients über AMQP, MQTT oder STOMP angebunden sind. Auch viele kleine, kurzlebige Queues, etwa eine pro Benutzersitzung, passen besser zu RabbitMQ als zu Kafka-Topics.
Share Groups mit Spring for Apache Kafka
Spring for Apache Kafka hat Share Consumer mit Version 4.0 eingeführt und mit Version 4.1 auf Basis von Kafka 4.2 als produktionsreif freigegeben.
Das Programmiermodell bleibt vertraut: Ein @KafkaListener wird über eine eigene Container-Factory zum Share Consumer.
Die Factories werden als Beans definiert, die Verbindungsdaten lassen sich aus der Spring-Boot-Konfiguration übernehmen:
@Configuration
class ShareConsumerConfig {

    @Bean
    ShareConsumerFactory<String, String> shareConsumerFactory(
            KafkaProperties kafka) {
        Map<String, Object> props = Map.of(
                BOOTSTRAP_SERVERS_CONFIG, kafka.getBootstrapServers(),
                KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class,
                VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        return new DefaultShareConsumerFactory<>(props);
    }

    @Bean
    ShareKafkaListenerContainerFactory<String, String>
            shareKafkaListenerContainerFactory(
                    ShareConsumerFactory<String, String> consumerFactory) {
        var factory =
                new ShareKafkaListenerContainerFactory<>(consumerFactory);
        // Vorübergehende Fehler erneut zustellen, alles andere ablehnen
        factory.setShareConsumerRecordRecoverer((record, ex) ->
                ex instanceof TransientException
                        ? AcknowledgeType.RELEASE
                        : AcknowledgeType.REJECT);
        return factory;
    }
}
Der Listener selbst unterscheidet sich von einem normalen Kafka-Listener nur durch die Container-Factory:
@KafkaListener(topics = "pdf-jobs", groupId = "pdf-worker",
        containerFactory = "shareKafkaListenerContainerFactory",
        concurrency = "8")
void render(ConsumerRecord<String, String> record) {
    pdfService.render(record.value());
}
Im Standardmodus EXPLICIT bestätigt der Container einen Record mit ACCEPT, wenn der Listener ohne Exception zurückkehrt.
Wirft der Listener eine Exception, entscheidet der ShareConsumerRecordRecoverer über RELEASE oder REJECT, ohne eigenen Recoverer wird abgelehnt.
concurrency = "8" startet acht Consumer-Threads, die jeweils als eigenes Mitglied der Share Group zählen, unabhängig davon, wie viele Partitionen das Topic hat.
Soll der Listener selbst entscheiden, wird die Factory auf ShareAckMode.MANUAL umgestellt und der Listener erhält ein ShareAcknowledgment:
@KafkaListener(topics = "pdf-jobs", groupId = "pdf-worker",
        containerFactory = "manualShareKafkaListenerContainerFactory")
void render(ConsumerRecord<String, String> record,
        ShareAcknowledgment ack) {
    try {
        pdfService.render(record.value());
        ack.acknowledge();
    } catch (TransientException e) {
        ack.release();
    } catch (Exception e) {
        ack.reject();
    }
}
Bei lang laufender Verarbeitung verlängert ack.renew() den Lock.
Wichtig im Modus MANUAL: Solange ein Record nicht bestätigt ist, ruft der betreffende Consumer-Thread keine neuen Records ab.
Einige Funktionen der normalen Listener-Container stehen für Share Consumer nicht zur Verfügung, darunter Batch-Listener, Message-Converter, seek und der CommonErrorHandler mit seiner Dead-Letter-Integration.
Fehlerbehandlung und Wiederholungen laufen stattdessen über die Bestätigungsarten und das Zustell-Limit des Brokers.
Auf der Producer-Seite ändert sich nichts, Nachrichten werden weiterhin mit dem KafkaTemplate in ein normales Topic geschrieben.
Für Teams, die von Spring AMQP kommen, ist der Umstieg bei einfachen Listenern überschaubar: Aus @RabbitListener mit manueller Bestätigung wird ein @KafkaListener mit Share-Container-Factory, basicAck und basicNack entsprechen acknowledge() und release() beziehungsweise reject().
Fazit
Share Groups schließen eine Lücke, die Kafka-Nutzer bisher mit Retry-Topics, vielen Partitionen oder einem zusätzlichen Broker überbrückt haben.
Für Arbeitswarteschlangen ohne Reihenfolgeanforderung bietet Kafka jetzt Einzelbestätigung, erneute Zustellung und Skalierung über die Partitionsanzahl hinaus.
Einen vollständigen Ersatz für RabbitMQ stellen sie nicht dar, insbesondere Routing, Prioritäten und Dead-Letter-Handling fehlen noch oder sind nicht vorgesehen.
In Spring-Anwendungen fügen sich Share Consumer über eine eigene Container-Factory in das bekannte @KafkaListener-Modell ein.
Wer Kafka und Spring for Apache Kafka in der Praxis kennenlernen möchte, findet dazu die folgenden Schulungen.