KI im Entwicklungsteam: Konsistenz, Review und Governance auf gemeinsamer Codebasis
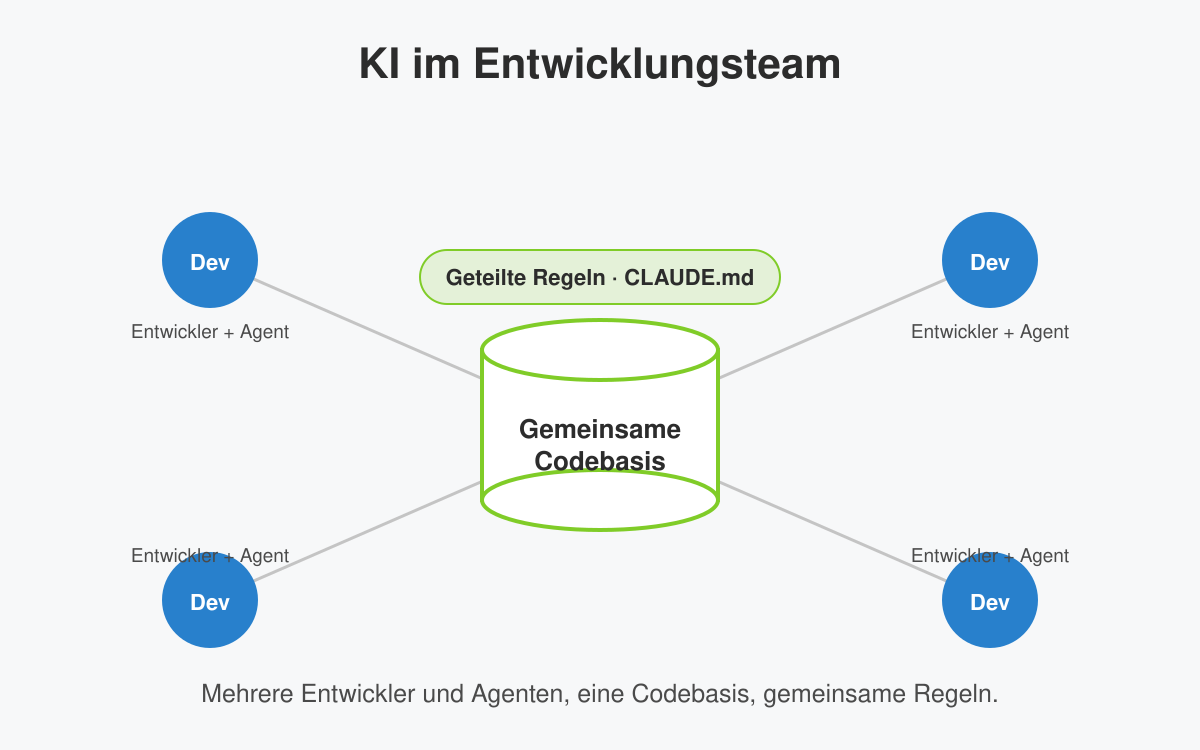
Der produktive Einsatz von KI-Werkzeugen durch einzelne Entwickler ist inzwischen gut verstanden. Die interessantere Frage stellt sich eine Ebene höher: Was passiert, wenn ein ganzes Team KI auf derselben Codebasis einsetzt.
Hier entstehen Probleme, die sich mit individueller Produktivität nicht lösen lassen. Dieser Beitrag ordnet die wichtigsten ein und zeigt, an welchen Stellen Teams ansetzen sollten.
Konsistenz und Drift
Wenn zehn Entwickler mit Agenten arbeiten, driften Stil und Architektur schneller auseinander als vorher. Jeder Agentlauf trifft eigene Annahmen, und ohne gemeinsame Vorgaben summieren sich diese zu einem uneinheitlichen Codebild.
Das Gegenmittel sind geteilte, versionierte Vorgaben im Repository. Agent-Regeln (etwa eine CLAUDE.md oder Rules-Files), Prompt- und Skill-Bibliotheken gehören in die Versionskontrolle und werden wie Code gepflegt. Wie Rollen, Anweisungen und Kontext in einem Agenten-Setup aufgeteilt werden können, beschreibt der Beitrag Mein OpenClaw-Setup: Weniger Prompt-Gepäck, klarere Aufgaben. Technische Leitplanken wie Linter und Architektur-Tests halten die KI-Ausgaben zusätzlich in der Spur, unabhängig davon, wer sie erzeugt hat.
Review im Maßstab
KI produziert mehr Code, und damit verschiebt sich die Last vom Schreiben zum Prüfen. Große, maschinell erzeugte Diffs sind schwerer zu reviewen, und die Verantwortung für einen KI-generierten Pull Request muss klar bei einer Person liegen.
Teams sollten ihr Review bewusst anpassen, statt es unverändert zu lassen. Das umfasst kleinere, klar abgegrenzte Änderungen, nachvollziehbare Herkunft und den gezielten Einsatz von KI auch im Review selbst.
Zusammenarbeit auf einer Codebasis
Mehrere Entwickler, die parallel Agenten laufen lassen, geraten sich leicht in die Quere. Hier helfen Scoping und Isolation, etwa über Git Worktrees, sowie klare Branch-Hygiene und Ownership, damit parallele Arbeit nicht in Merge-Konflikten endet.
Geteilte Wissensinfrastruktur
Vieles, was KI im Team nützlich macht, ist gemeinsame Infrastruktur. Ein internes RAG über die eigene Codebasis und Dokumentation macht firmenspezifisches Wissen für die Agenten zugänglich. Firmeneigene MCP-Server stellen interne Tools und Datenquellen bereit, müssen aber auch betrieben und gepflegt werden. Wie ein solcher MCP-Server mit Spring AI umgesetzt wird, beschreibt der Beitrag Spring AI MCP-Server: Spring-Dokumentation für LLMs bereitstellen.
Governance, Sicherheit und Recht
Auf Team- und Unternehmensebene kommen Fragen hinzu, die den einzelnen Entwickler nicht betreffen. Welche Tools und Modelle sind erlaubt, welche Codeteile dürfen zu welchem Anbieter, und wann müssen sensible Teile über lokale Modelle laufen. Dazu kommen Sicherheitsthemen wie Prompt Injection über geteilten Kontext, Slopsquatting bei vorgeschlagenen Dependencies, der Umgang mit Secrets in Agent-Kontexten und Sandboxing in der CI. Regulatorisch geben DSGVO und EU AI Act den Rahmen vor.
Rollout und Messung
Die Einführung sollte geplant und begleitet werden, nicht dem Zufall überlassen. Dazu gehören eine bewusste Tool- und Modellwahl, Token-Budgets über das Team, eine ehrliche Produktivitätsmessung statt Vanity-Metriken sowie Change-Management und Skill-Leveling.
Fazit
KI im Entwicklungsteam ist kein reines Werkzeugthema, sondern eine Frage von Konventionen, Prozessen und Infrastruktur. Teams, die geteilte Regeln, ein angepasstes Review und klare Governance etablieren, holen aus KI mehr heraus und vermeiden die typischen Folgeprobleme auf gemeinsamer Codebasis.
Diese Themen vertiefen wir in unseren Schulungen zum KI-Einsatz in der Softwareentwicklung: