Lokale KI betreiben: sensible Daten, air-gapped Umgebungen und Kubernetes
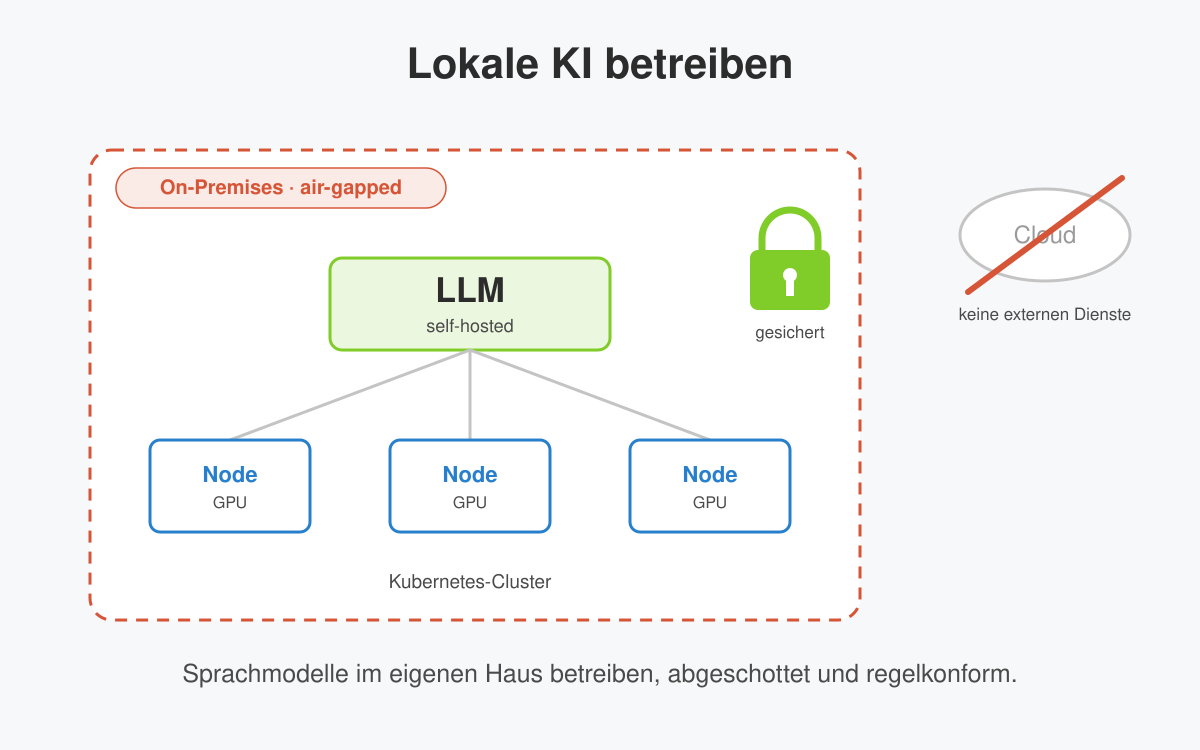
Nicht jede Organisation kann oder darf KI-Dienste in der Cloud nutzen. Sensible Daten, regulatorische Vorgaben, Souveränitätsanforderungen und abgeschottete Netze verlangen den Betrieb von Sprachmodellen im eigenen Haus.
Das ist technisch machbar, stellt aber eigene Anforderungen an Betrieb, Sicherheit und Compliance. Dieser Beitrag ordnet die wichtigsten ein.
Warum lokal
Der Grund ist selten Kostenoptimierung, sondern Kontrolle. In regulierten Branchen wie Finance, Public Sector, Gesundheit oder Verteidigung dürfen bestimmte Daten das eigene Netz nicht verlassen. Lokaler Betrieb hält Daten, Modelle und Embeddings im Haus und macht den Datenfluss nachvollziehbar.
Modelle, Serving und Kubernetes
Die Grundlage sind Open-Weight-Modelle, die sich selbst hosten lassen. Über Quantisierung und passendes Hardware-Sizing wird der Kompromiss zwischen Qualität, Durchsatz und Kosten eingestellt. Für das Serving haben sich Stacks wie llama.cpp, vLLM, Ollama und TGI etabliert, meist mit einer OpenAI-kompatiblen API.
Betrieblich passt das gut zu Kubernetes. GPU-Scheduling, Node-Pools, Modell-Storage, Skalierung und kontrollierte Rollouts sind dort bereits gelöste Probleme, und das vorhandene Betriebs-Know-how lässt sich direkt anwenden.
Air-gapped Betrieb
In abgeschotteten Umgebungen gibt es keinen Internetzugang, und das ändert die Abläufe grundlegend. Modelle und Abhängigkeiten müssen offline bereitgestellt werden, über interne Registries und Mirrors. Updates und Patches brauchen einen definierten Prozess ohne externe Quellen, und die Integrität der Modellgewichte muss überprüfbar sein, inklusive ihrer Herkunft.
Sicherheit
Ein lokal betriebenes Modell ist nicht automatisch sicher. Dazu gehören Netzisolation und Segmentierung, Authentifizierung und Autorisierung etwa über Keycloak, sauberes Secrets-Management sowie Logging und Audit. Auch beim lokalen Betrieb bleiben Prompt Injection und Daten-Exfiltration relevant und müssen adressiert werden.
Agentische KI mit lokalen Modellen
Wer lokal nicht nur chatten, sondern Agenten einsetzen möchte, stößt auf eine zusätzliche Hürde. Agentische Abläufe hängen stark von zuverlässigem Tool- und Function-Calling ab, und hier unterscheiden sich lokale Modelle deutlich. Es lohnt sich, Modell und Agent-Harness aufeinander abzustimmen, die Grenzen lokaler Modelle in mehrstufigen Abläufen zu kennen und MCP-Server und Werkzeuge auch im abgeschotteten Betrieb bereitzustellen.
Compliance und Souveränität
Der lokale Betrieb ist oft die Antwort auf regulatorische Anforderungen, nimmt einem die Dokumentation aber nicht ab. DSGVO und EU AI Act geben den Rahmen vor, und für viele Behörden und Betreiber kritischer Infrastruktur kommt der BSI-Grundschutz hinzu. Entscheidend ist, den Betrieb so aufzusetzen, dass er diese Anforderungen nachweisbar erfüllt.
Fazit
Lokale KI ist kein exotisches Nischenthema, sondern für viele Organisationen die einzige gangbare Option. Mit Open-Weight-Modellen, einem passenden Serving-Stack auf Kubernetes und einem klaren Konzept für Abschottung, Sicherheit und Compliance lässt sie sich produktionsreif betreiben.
Diese Themen vertiefen wir in unserer Schulung zum Betrieb lokaler KI und den passenden Kubernetes- und Security-Schulungen: